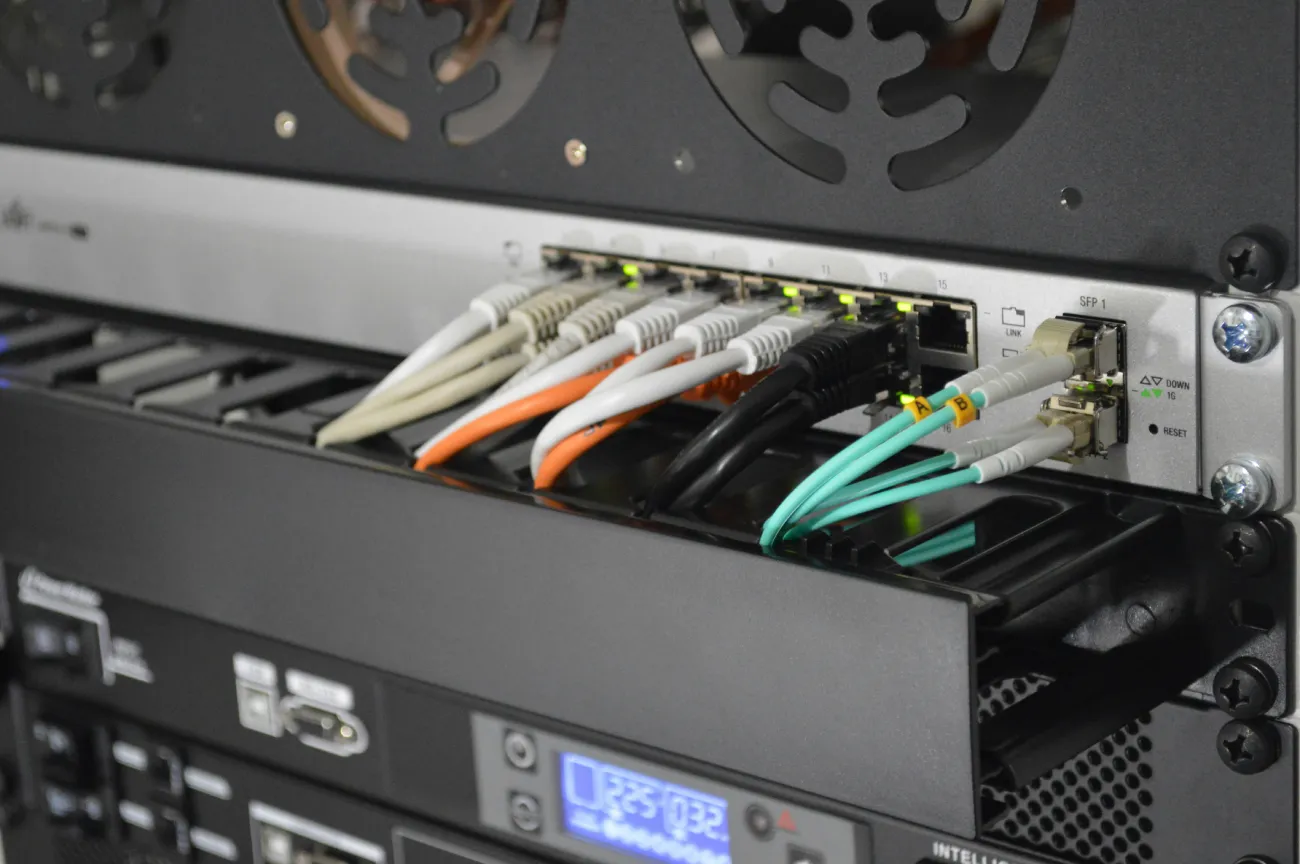

Корпоративни хостинг је темељ на коме се ослањају веб странице, апликације, базе података и свакодневни пословни процеси. Када је услуга стабилна, тимови раде без прекида, корисници имају брз приступ садржају, а компанија избегава непланиране трошкове. Али стабилност се не дешава сама од себе. Она захтева пажљиво праћење, прецизну анализу и благовремен одговор. Најбољи приступ је постављање система који не само да детектује проблеме, већ и објашњава њихове узроке.
1. Дефинишите јасне индикаторе учинка
Први корак у праћењу корпоративног хостинга јесте одређивање метрика које су заиста важне за пословање. Време непрекидног рада, време одзива, латенција, искоришћеност процесора, РАМ меморија, простор на диску и мрежни саобраћај су основне метрике, али постају корисне само када су повезане са одређеним пословним циљевима. На пример, ако продајни портал мора бити доступан 24/7, онда чак и кратки прекиди могу имати стваран финансијски утицај.
Добра је пракса поставити основне вредности за сваку услугу. На овај начин, уместо гледања сирових бројева без контекста, тим ће знати шта је нормално, шта је упозорење, а шта је критичан проблем. Овај приступ такође олакшава извештавање менаџменту, јер се технички подаци трансформишу у јасну слику стабилности инфраструктуре.
2. Пратите инфраструктуру у реалном времену
Реално време је кључно када је у питању корпоративни хостинг. Ако се праћење одложи, проблем се може проширити пре него што ико примети. Стога, системи за праћење треба да пруже тренутни увид у здравље сервера, апликативних сервиса, база података и мрежне повезаности. Најважније је обратити пажњу на трендове, а не само на појединачне скокове.
Фокусирајте се на симптоме који претходе престанку
Често су први знаци нестабилности повећана латенција, неуобичајен број захтева серверу, повећање 5xx грешака или успорено извршавање базе података. Ако се ови сигнали редовно прате, могуће је интервенисати пре него што корисници доживе проблем. Ово је посебно важно за компаније са великим прометом или критичним интерним системима.
3. Користите централизовано евидентирање и анализу
Записи су један од највреднијих извора информација приликом анализе хостинг сервиса. Уместо да их прегледате на више локација, боље је прикупити све податке на једном месту. Централизовано евидентирање омогућава брже откривање образаца, поређење догађаја и идентификацију узрока. Ово је посебно корисно када квар није трајан, већ се јавља повремено и тешко га је репродуковати.
Анализа логова може открити много више од пуке техничке грешке. Може открити недоследна ажурирања, лоше конфигурисане услуге, неочекиване захтеве купаца или чак безбедносне инциденте. Са добро организованим логовима, тим не гаси пожаре слепо, већ ради са доказима и контекстом.
4. Подесите интелигентне аларме и ескалације
Превише аларма може бити подједнако проблематично као и премало. Ако тим стално прима обавештења без икакве стварне опасности, настаје замор од аларма и важна упозорења се лако игноришу. Зато аларме треба подесити интелигентно, са јасним праговима и приоритетима према утицају на пословање.
На пример, аларм за 70% искоришћености ресурса може бити информативан, али аларм за изненадно повећање латенције или пад одређене услуге мора одмах да иде одговорној особи. Добро је имати различите нивое ескалације, како бисте знали када се проблем може решити током радног дана, а када је потребна хитна интервенција дежурног инжењера.
5. Редовно вршите тестирање капацитета
Многе организације прате тренутни статус свог хостинга, али не размишљају довољно о будућем расту. Планирање капацитета је суштински део анализе, јер успех једне услуге може створити нова оптерећења. Ако саобраћај расте, а инфраструктура остане иста, систем ће постепено постајати спорији и мање стабилан.
Зато је корисно покретати тестове оптерећења и симулације током вршних периода. На овај начин, тим може да види како се хостинг понаша под притиском, где се јављају уска грла и када је време за надоградњу. На дужи рок, ово штеди новац, јер је боље планирати инвестицију унапред него реаговати након прекида услуге.
Анализирајте трендове, не само тренутне вредности
Један дан велике употребе не значи да је инфраструктура недовољна. Али ако се иста слика понавља неколико недеља заредом, то је јасан сигнал да се ресурси приближавају граници. Трендови су најјачи показатељ будућих проблема и зато морају бити део сваког озбиљног праћења.
6. Повежите праћење са безбедношћу и резервним копијама
Стабилност није само ствар перформанси, већ и безбедности. Необични приступи, сумњиви покушаји пријављивања, промене конфигурације и неочекивани мрежни саобраћај могу бити знаци напада или злонамерне интервенције. Када је праћење безбедности интегрисано са праћењем хостинга, проблеми се откривају брже и са мањим ризиком.
Подједнако је важно редовно проверавати резервне копије. Није довољно да постоје; морају се тестирати да би се видело да ли се заиста могу вратити у функционално стање. У критичним пословним окружењима, добро организован план прављења резервних копија и опоравка од катастрофе део су исте приче као и перформансе и стабилност. Уколико дође до прекида рада, брз опоравак може направити разлику између кратке непријатности и озбиљног пословног инцидента.
Када се корпоративни хостинг систематски прати, тим добија много више од само техничких бројева: добија сигурност, предвидљивост и јасну основу за одлуке. Најбољи резултати се постижу када праћење, евидентирање, аларми, планирање капацитета и безбедносне провере раде заједно. Тада је инфраструктура не само стабилна у овом тренутку, већ и спремна да подржи раст, промене и повећане захтеве без непотребног ризика.
Често постављана питања
Зашто је важно повезати метрике хостинга са пословним циљевима, а не само пратити техничке бројке?
Јер сами бројеви не говоре да ли проблем заиста утиче на ваше пословање. На пример, 2 минута застоја могу бити безначајна за интерни портал, али критична за продајни систем. Када су метрике повезане са циљевима, тим може лакше да одреди приоритете, а менаџмент може да добије јасну слику о ризику и утицају.
Да ли је праћење у реалном времену само по себи довољно да се спрече прекиди?
Не увек. Анализа у реалном времену помаже да се проблем одмах уочи, али често не објашњава зашто се дешава. Зато је важно комбиновати је са анализом трендова, логова и историјских података. На овај начин, рани симптоми, као што су повећање латенције или неуобичајен број грешака, могу се препознати пре него што дође до прекида рада.
Како централизовано евидентирање помаже када се проблем ретко јавља и тешко га је репродуковати?
Ту је најкорисније. Када се логови прикупљају на једном месту, можете упоредити времена, услуге и догађаје у целој вашој инфраструктури. Ово вам помаже да видите шта се догодило непосредно пре грешке, чак и ако се то не може лако реплицирати. Ово вам помаже да брже дођете до корена проблема.
Како избећи „замор од аларма“ без пропуштања важних инцидената?
Постављањем јасних прагова, приоритета и нивоа ескалације. Не би свака промена требало да покрене упозорење о ванредном стању; неки сигнали су само у информативне сврхе. Важно је повезати упозорења са стварним утицајем на услугу, како тим не би био преоптерећен непотребним обавештењима и како би реаговао само када је то заиста неопходно.
Колико често треба тестирати капацитет хостинг инфраструктуре?
Не постоји универзално правило, али тестирање треба редовно обављати и кад год дође до значајне промене: раст саобраћаја, нова апликација, веће кампање или надоградње инфраструктуре. Идеја није чекати да се појави уско грло. Тестови капацитета помажу да се открије колико систем може безбедно да расте.
